Ai2 研究:我们能否信任大语言模型判断研究想法是否新颖
Can we trust LLMs to judge whether a research idea is novel?
Ai2 发布研究 Old Ideas, Novel Problems 与评测基准、数据及代码,测试大语言模型判断科研想法新颖性的可靠性,发现提示词微调可使同一模型准确率波动超 50 个百分点。测试涵盖 GPT-5.1、Claude Opus 4.6 等六模型,且检索与额外推理未稳定提升判断,专用评估系统成本更高却弱于简单提示基线。该基准与流水线已开放,可应用于新审稿与其他科学社区。
该研究发布新颖性判断基准与开源流水线,可供研究者量化自动科学发现流程里原创性评估的不稳定性与影响因素。
今天,我们发布了 旧想法,新问题,这是一项关于大型语言模型评估科学研究想法新颖性的可靠程度的新研究。除了论文外,我们还发布了用于测试新颖性评判器的基准、数据和代码,以及研究人员可用于构建新评估集的自动化流水线。
在 Ai2,我们一直在开发支持科学发现不同环节的 AI 系统。DataVoyager 帮助研究人员探索和分析结构化数据,AutoDiscovery 生成并测试假设,Theorizer 将大量文献中的证据综合为候选科学理论。与 Asta 一起,这些项目指向了能够帮助研究人员从理解先前工作到提出、测试和完善新想法的系统。
但生成研究想法只是自动化科学发现挑战的一部分。这些想法还需要贡献一些真正新颖的内容,这意味着这些系统需要一种方式来区分新颖的方向和主要重新包装现有工作的方向。
这种判断通常交给另一个 LLM——我们称之为新颖性评判器。新颖性评判器评估研究想法相对于先前工作是否新颖,无论是单独评估还是与另一个想法进行比较。构建评判器没有标准方法;研究团队选择模型、提示、评估格式、推理预算,有时还有文献检索系统。这些选择可能会实质性地影响判断结果。然而,这些评判器通常仅在人类撰写的论文上进行验证,而不是它们实际旨在评估的 AI 生成的想法。
我们的新基准结果表明,新颖性评估本身远不可靠。在六个 LLM 评判器——GPT-5.1、GPT-5.2、GPT-5.4、Claude Sonnet 4.5、Claude Opus 4.5 和 Claude Opus 4.6——中,对评估设置的看似微小的更改会产生对同一想法截然不同的判断。在一项实验中,仅更改提示中的几个词,模型在识别两个想法中哪个更新颖方面的准确率就偏移了超过 50 个百分点。检索和额外推理并不一致地改善判断,两个专门构建的新颖性评估系统的表现甚至不如简单的提示 Claude Opus 4.6 基线。
如果 AI 要在科学发现中发挥更大的作用,我们需要更可靠的方式来判断它是否真的提出了新东西。我们的工作提供了研究该问题的工具,同时展示了仍有大量未解决的问题。
为新颖性评判器构建基准
为了测试新颖性评判器区分更新颖的研究想法和较不新颖的研究想法的可靠程度,我们首先需要关于底层科学贡献原创性的强证据示例。
因此,我们围绕 ICLR 2026 同行评审构建了一个自动化流水线。我们不是将论文接收作为新颖性的代理,而是从评审中挖掘评论者明确讨论贡献原创性的段落。这一区别至关重要;一篇论文即使不够新颖,只要在其他方面足够强,也可以被接收。同样,一篇具有原创贡献的被拒论文可能还有其他弱点。
我们构建了一个包含 154 个人工撰写研究想法的高新颖度池,选取标准是:在 ICLR 研究领域评分最高的前 10% 中被接受的论文,其审稿人正面指出了新颖性,且没有审稿人对此提出异议。我们应用反向标准构建了一个低新颖度池:包含 145 个来自评分最低的后 10% 中被拒论文的想法,其审稿人提出了原创性疑虑,且没有审稿人正面指出新颖性。在对审查挖掘流程的独立检查中,一名标注者在 50 个案例中的 47 个里与提取的新颖性信号极性一致;所有不一致的情况都不会改变某位审稿人是否被计为赞扬或质疑论文新颖性的结果。
这两个池共同构成了我们的第一个评估设置,仅人工(Human-Only),用于测试新颖性评判者能否区分具有较高或较低新颖性强证据的人工撰写想法。但在实践中,新颖性评判者越来越多地被用于评估 AI 生成的想法。因此,我们创建了第二个设置,人工+生成(Human+Generated)。
对于这个池,我们将相同的 154 个经过验证的人工想法与由一个简单的 LLM 生成器产生的 154 个想法配对。我们假设生成的想法比其人工撰写的对应物新颖性较低;这些是弱标签,而非针对每个想法的已验证判断。生成器仅接收一个研究领域和提出新颖想法的指令,没有文献检索、工具、迭代或反馈。这为我们提供了一个保守的比较,对比来自基础生成器的想法和来自 ICLR 前 10% 论文的贡献,后者的审稿人已明确认可其原创性。
作为额外的检查,一位专家独立审查了 30 个人工+生成(Human+Generated)配对,重点加权于我们最强的评判者判断错误的案例,并且我们将人工和 AI 生成的想法重写为共同结构,以测试评判者是否仅仅是对写作风格的差异做出反应。专家在所有 30 个配对中更偏好人工想法,并判断没有任何生成的想法具有新颖性。
重要的是,我们的许多核心发现根本不依赖于标签。如果两个合理的评估设置对同一对想法给出相反的答案,这种分歧本身就揭示了不稳定性。
微小的变化可能产生截然不同的裁决
利用我们收集的人工撰写和 AI 生成的研究想法,我们测试了六个 LLM 评判者——GPT-5.1、GPT-5.2、GPT-5.4、Claude Sonnet 4.5、Claude Opus 4.5 和 Claude Opus 4.6——通过逐点(即绝对新颖性评分)和成对(即比较两个想法以找出最具新颖性的)比较来评估新颖性的能力。我们每次只改变一个因素:提示词、推理预算、评判者是否能看到相关论文、想法的格式、多少个判断被合并为最终裁决,以及——对于 AI 生成的想法——是哪个模型生成的。
性能最大的变化来自于我们如何提示模型判断新颖性。
例如,我们向 GPT-5.4 展示了相同的 Human+Generated 配对——每对包含一个经过验证的人类构思和一个 AI 生成的构思——并使用了两种提示词。一种提示词告诉模型,评审员发现每对中有且仅有一个构思具有新颖性,并要求其识别出是哪一个;另一种则简单地询问哪个构思具有新颖性。当我们切换到更简单的提示词时,准确率从 93.5% 降至 40.9%——低于随机猜测水平——且模型在超过一半的相同配对上改变了判定结果。
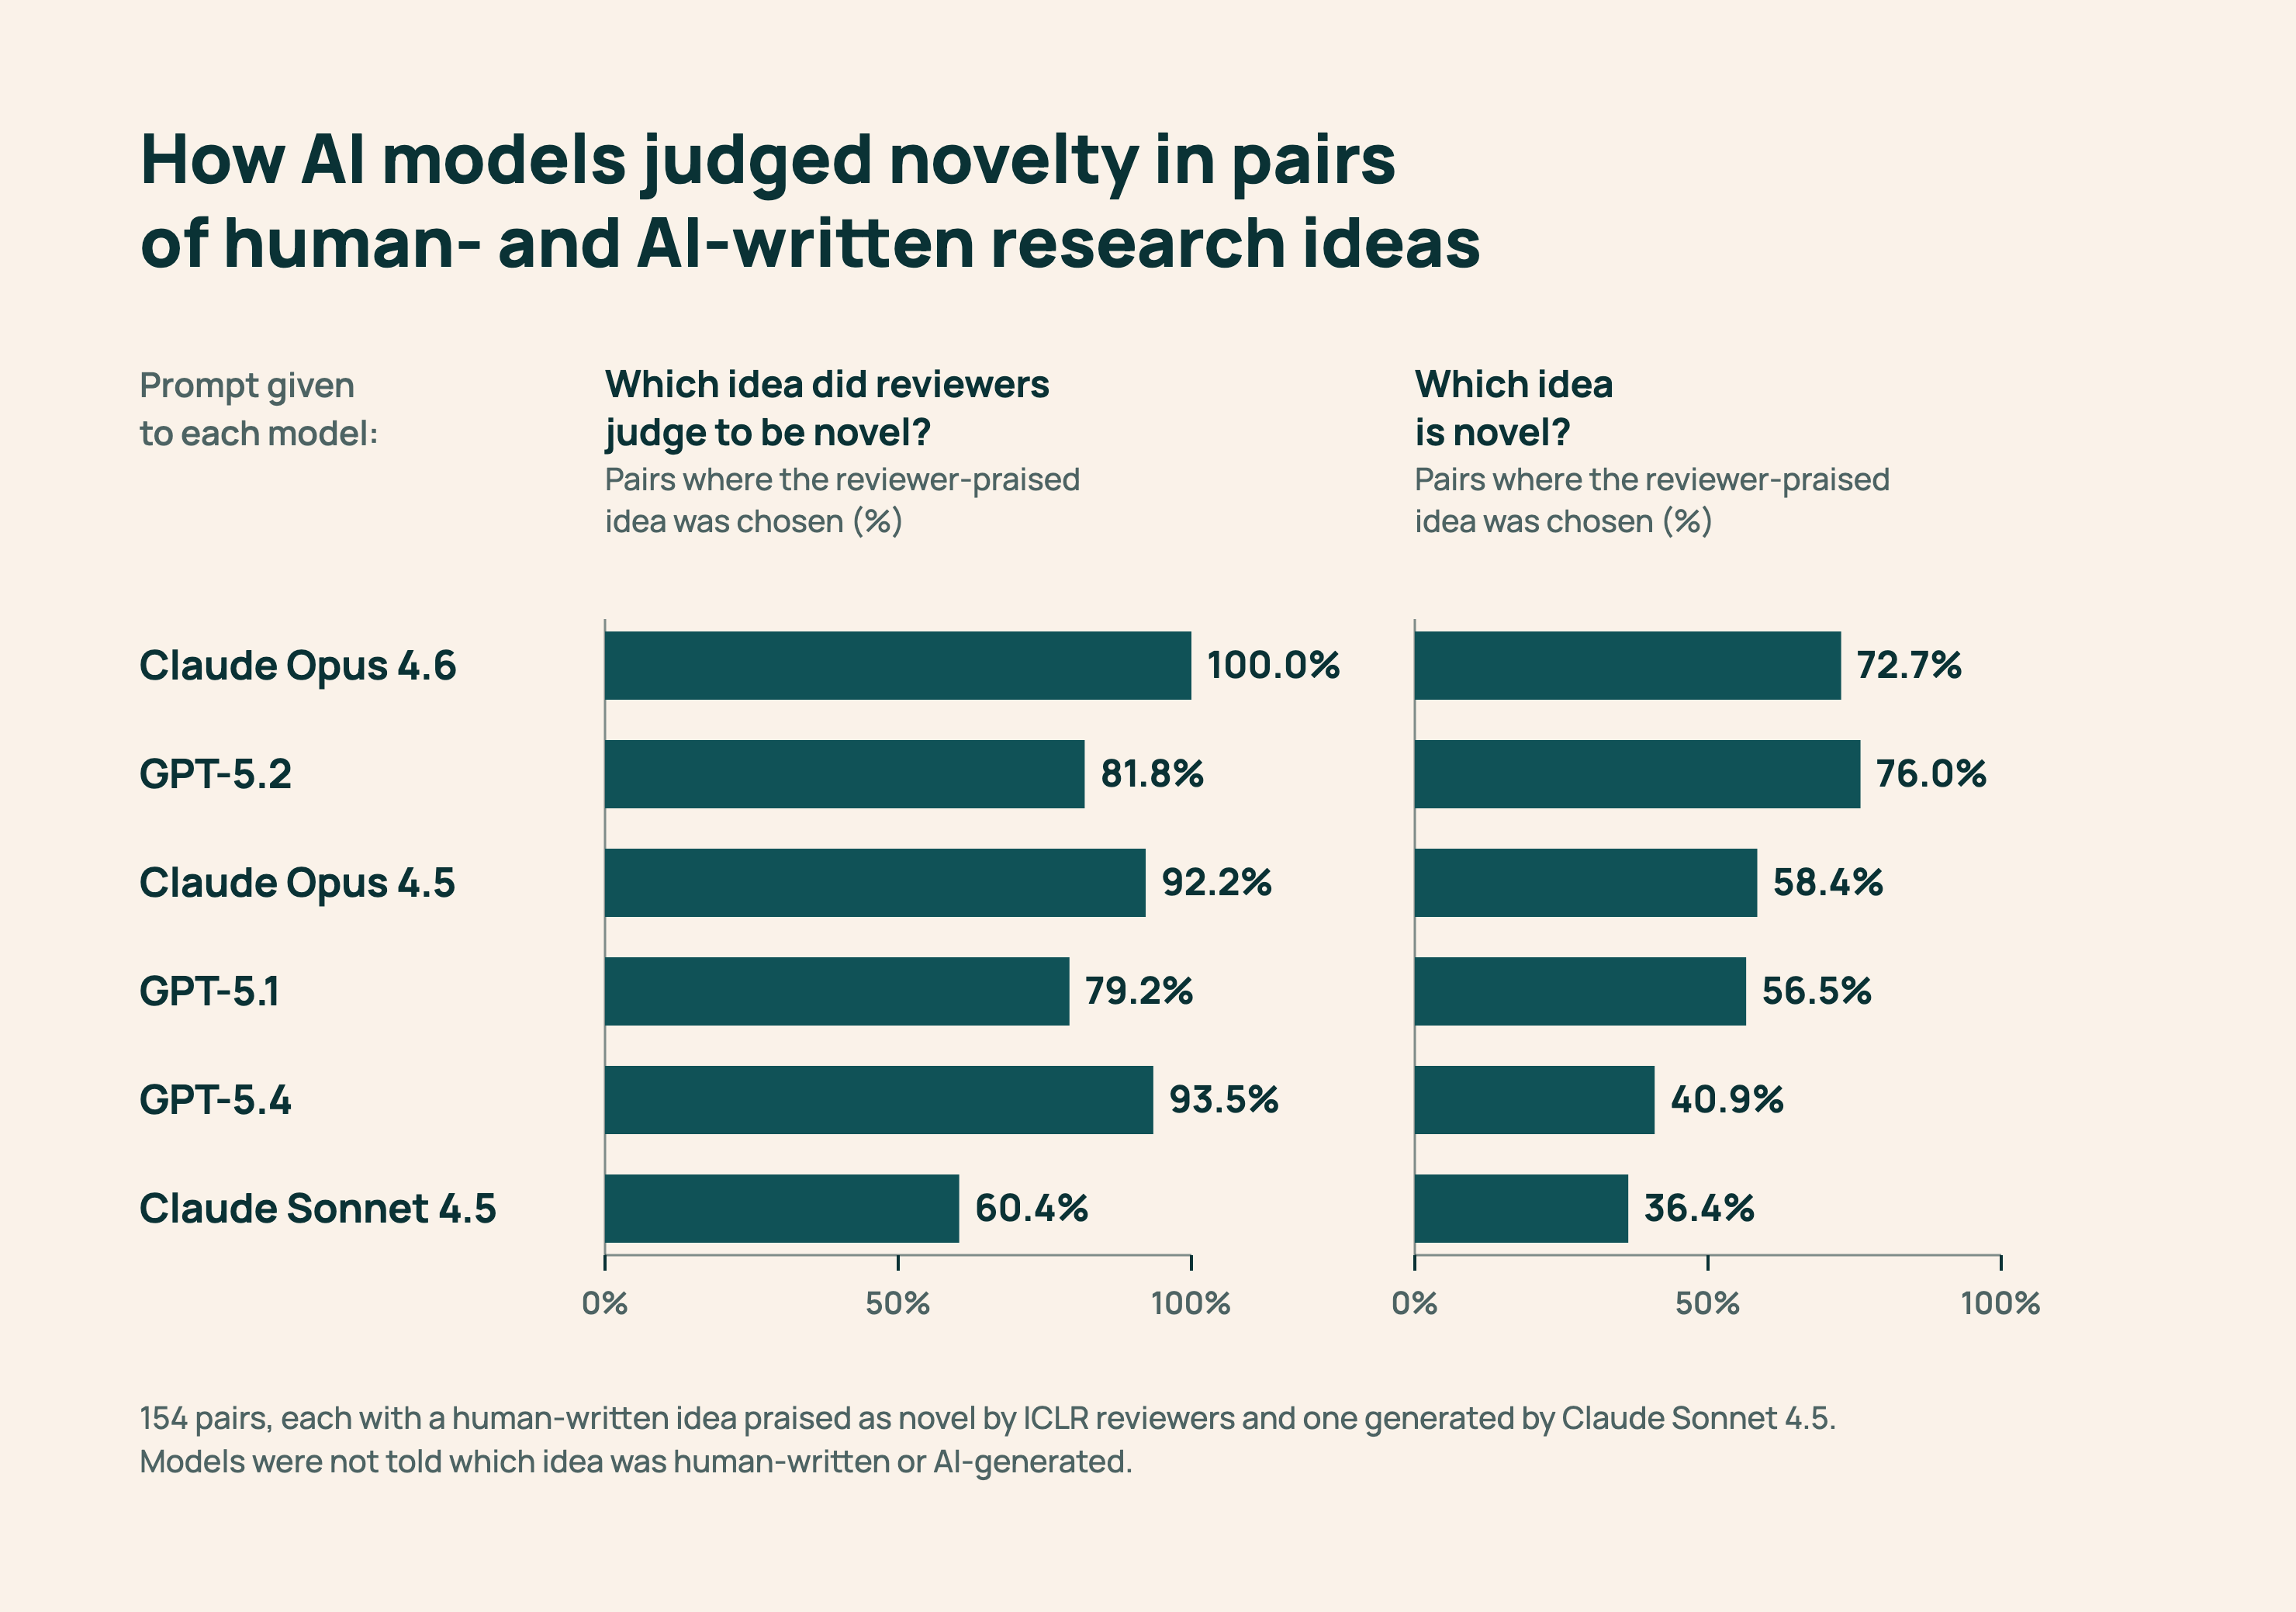
相比之下,同样的提示词变更在 Human-Only 数据集上仅使准确率变化了约七个百分点,该数据集将人类构思与具有更强或更弱新颖性证据的构思进行配对。这表明,新颖性评判器在人类研究上可能显得相对稳定,但在 AI 生成的构思上表现却大相径庭。
话虽如此,人类构思也并非免疫。我们在 Human-Only 数据集上也观察到了显著的变化;同样的变更使 Claude Opus 4.6 的准确率移动了 21 个百分点。只是这些变化不如在 AI 生成构思上那么严重。
此外,也不存在普遍更优的提示词。例如,在单独评判构思时,移除一条警告评判器不要将琐碎或增量式贡献视为新颖的指令,提高了某些评判器的准确率,却降低了其他评判器的准确率。换言之,对某个模型效果良好的提示词可能无法迁移到另一个模型。
我们还测试了新颖性评判器的一种常见用途:比较来自两个 AI 生成器的构思。我们将 Claude Opus 4.5 的构思与 Claude Sonnet 4.5 配对,将 GPT-5.4 与 GPT-5.1 配对。在测试的提示词变更中,六个评判器平均有大约四分之一到三分之一的判定结果发生了改变。这种分歧可以在不假设哪个生成器产生更多新颖构思的情况下进行测量,从而展示了评判器提示词的选择如何影响构思系统之间的比较。
更多的搜索和推理并不一定产生更好的新颖性判断。我们赋予 GPT-5.6 Sol 一个超高的推理预算和限制在 arXiv 上的实时迭代搜索,然后将其与每个仅查看五个预检索摘要的标准检索评判器进行比较。(在此比较中,所有评判器在 Human+Generated 上每个构思运行一次。)该智能体评判器获得了 0.78 的 macro-F1 分数——比 Claude Opus 4.6 的 0.89 低 11 个百分点,且大致与更简单的 Claude Opus 4.5 和 GPT-5.4 设置处于同一范围——而在当前 API 价格下,每次决策的成本大约高出 10 倍。(在此语境下,macro-F1 衡量评判器识别新颖和非新颖构思的能力;分数越高越好。)
尽管成本大幅增加,专用评估器也并未更准确。在 Human+Generated 集合上,一个使用低推理并在三次调用中进行多数投票的简单 Claude Opus 4.6 提示词,以 2.59 美元的总评估成本实现了 0.854 的 macro-F1。相比之下,Idea Novelty Checker(一个基于文献的检索和重排序管道)以 30.66 美元的成本获得了 0.642 的分数,而 Sakana AI 的 AI Scientist(其新颖性评估器迭代搜索 Semantic Scholar)以 82.05 美元的成本获得了 0.772 的分数。(这两个专用评估器均使用 Claude Opus 4.6,每次决策调用一次。)
换言之,简单的提示词基线比这两个专用系统都更准确,且成本低得多。
综合来看,这些结果表明,新颖性评估在这些系统日益被要求评判的 AI 生成构思上特别脆弱。
迈向对新颖研究的更可靠评估
我们的结果表明,基于大语言模型的新颖性评估仍是一个主要的未解决问题。在人类撰写的研究中看似可靠的评审模型,在评估 AI 生成的想法时可能表现不同;有助于一个模型的提示词可能会损害另一个模型的表现;并且更多的搜索或计算并不一定能产生更一致的判断。
未来的工作应在评审模型实际将要评估的那类想法上对其进行测试,衡量其对不同提示词和模型的敏感性,改进先前文献的整合方式,并构建能够随着科学文献的增长和 AI 系统的改进而演进的基准。我们的基准和可复用的数据管道是一个起点——研究人员可以将其应用于新的同行评审、其他科学社区以及未来几代新颖性评审模型。
自动化构思不仅依赖于生成看似合理的研究方向;我们还需要方法来判断这些想法是否真正新颖。通过使当前新颖性评审模型的弱点更容易被衡量,我们希望此次发布能帮助研究人员构建更稳健的方法来评估 AI 生成的研究想法。
来源:Hugging Face Blog · huggingface.co